道路標識をAIで検知する 走りながら撮った画像から標識を見つけ、5つに分ける
車に載せたスマートフォンやドライブレコーダーで前方を撮った画像から、日本の道路標識を見つけ、案内・警戒・規制・指示・補助の5つに分ける検出モデルを公開しました。
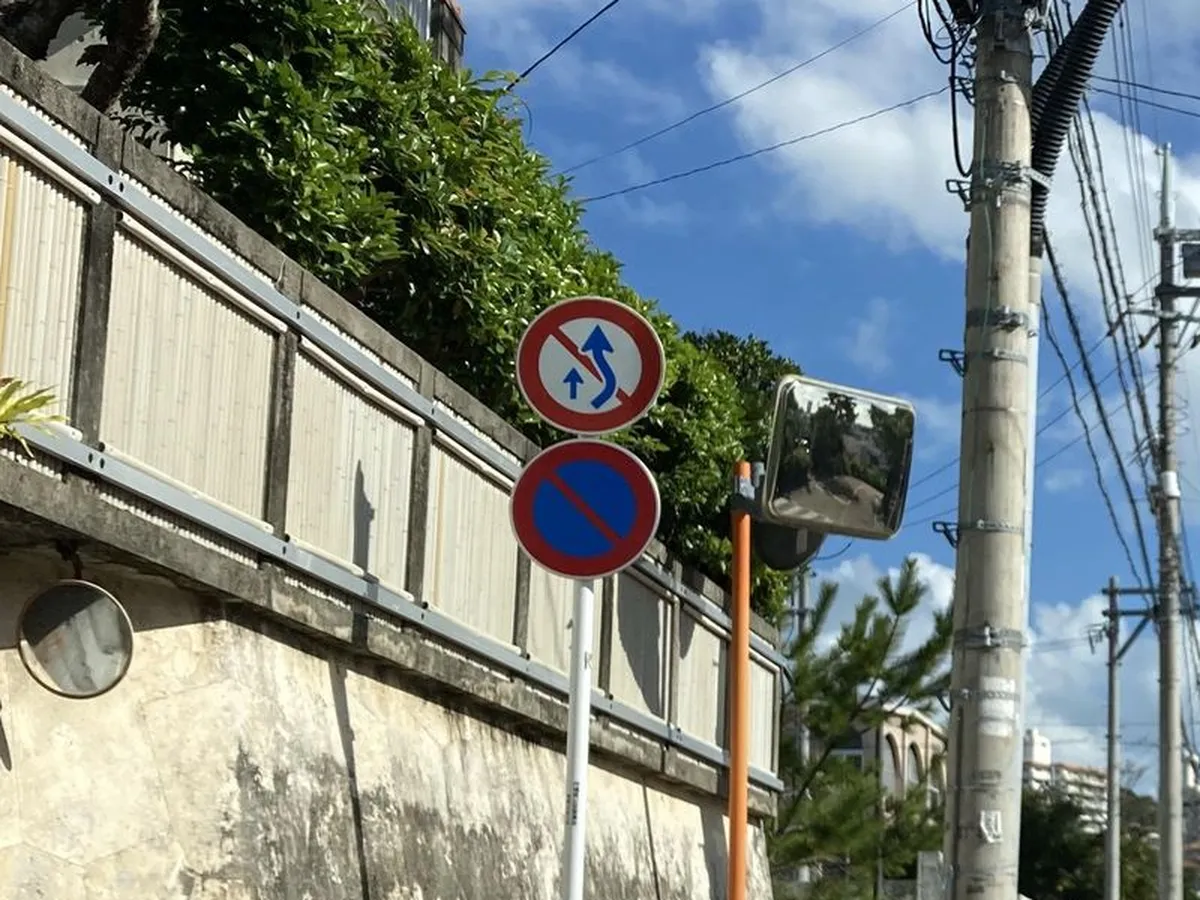
車に載せたスマートフォンやドライブレコーダーで前方を撮った画像から、道路標識を見つける検出モデルを、モデルラボで公開しました。見つけた標識は、形と色で案内・警戒・規制・指示・補助の5つに分けます。重みは開発者向けに Apache-2.0 で公開していて、業務のシステムにも組み込めます。
何のために、標識を見つける?
道路標識は、色あせたり、向きがずれたり、木の枝に隠れたりします。管理する側がそれに気づくには、どこに、どの標識が立っているかが先に分かっている必要があります。
標識の点検や、標識の台帳を作り直す作業の中で、1本ずつ現地で位置と種類を確かめなければならない場面があります。走りながら撮った画像から標識を抽出できれば、現地確認の前の洗い出しを車1台で進められます。検出した標識の写真と撮影位置を並べれば、台帳の下書きや、前回の記録との比較に使えます。
誰が使う?
- 道路を管理する国・自治体・高速道路会社の、標識の点検や台帳の担当
- 点検や台帳の作成を請け負う会社
- 走行映像から地図や道路のデータを作る会社や研究者
いずれも、大量の画像から標識の写ったフレームと標識の位置を抽出する作業を、目視だけで行っている場面に向いています。
どうやって見つけている?
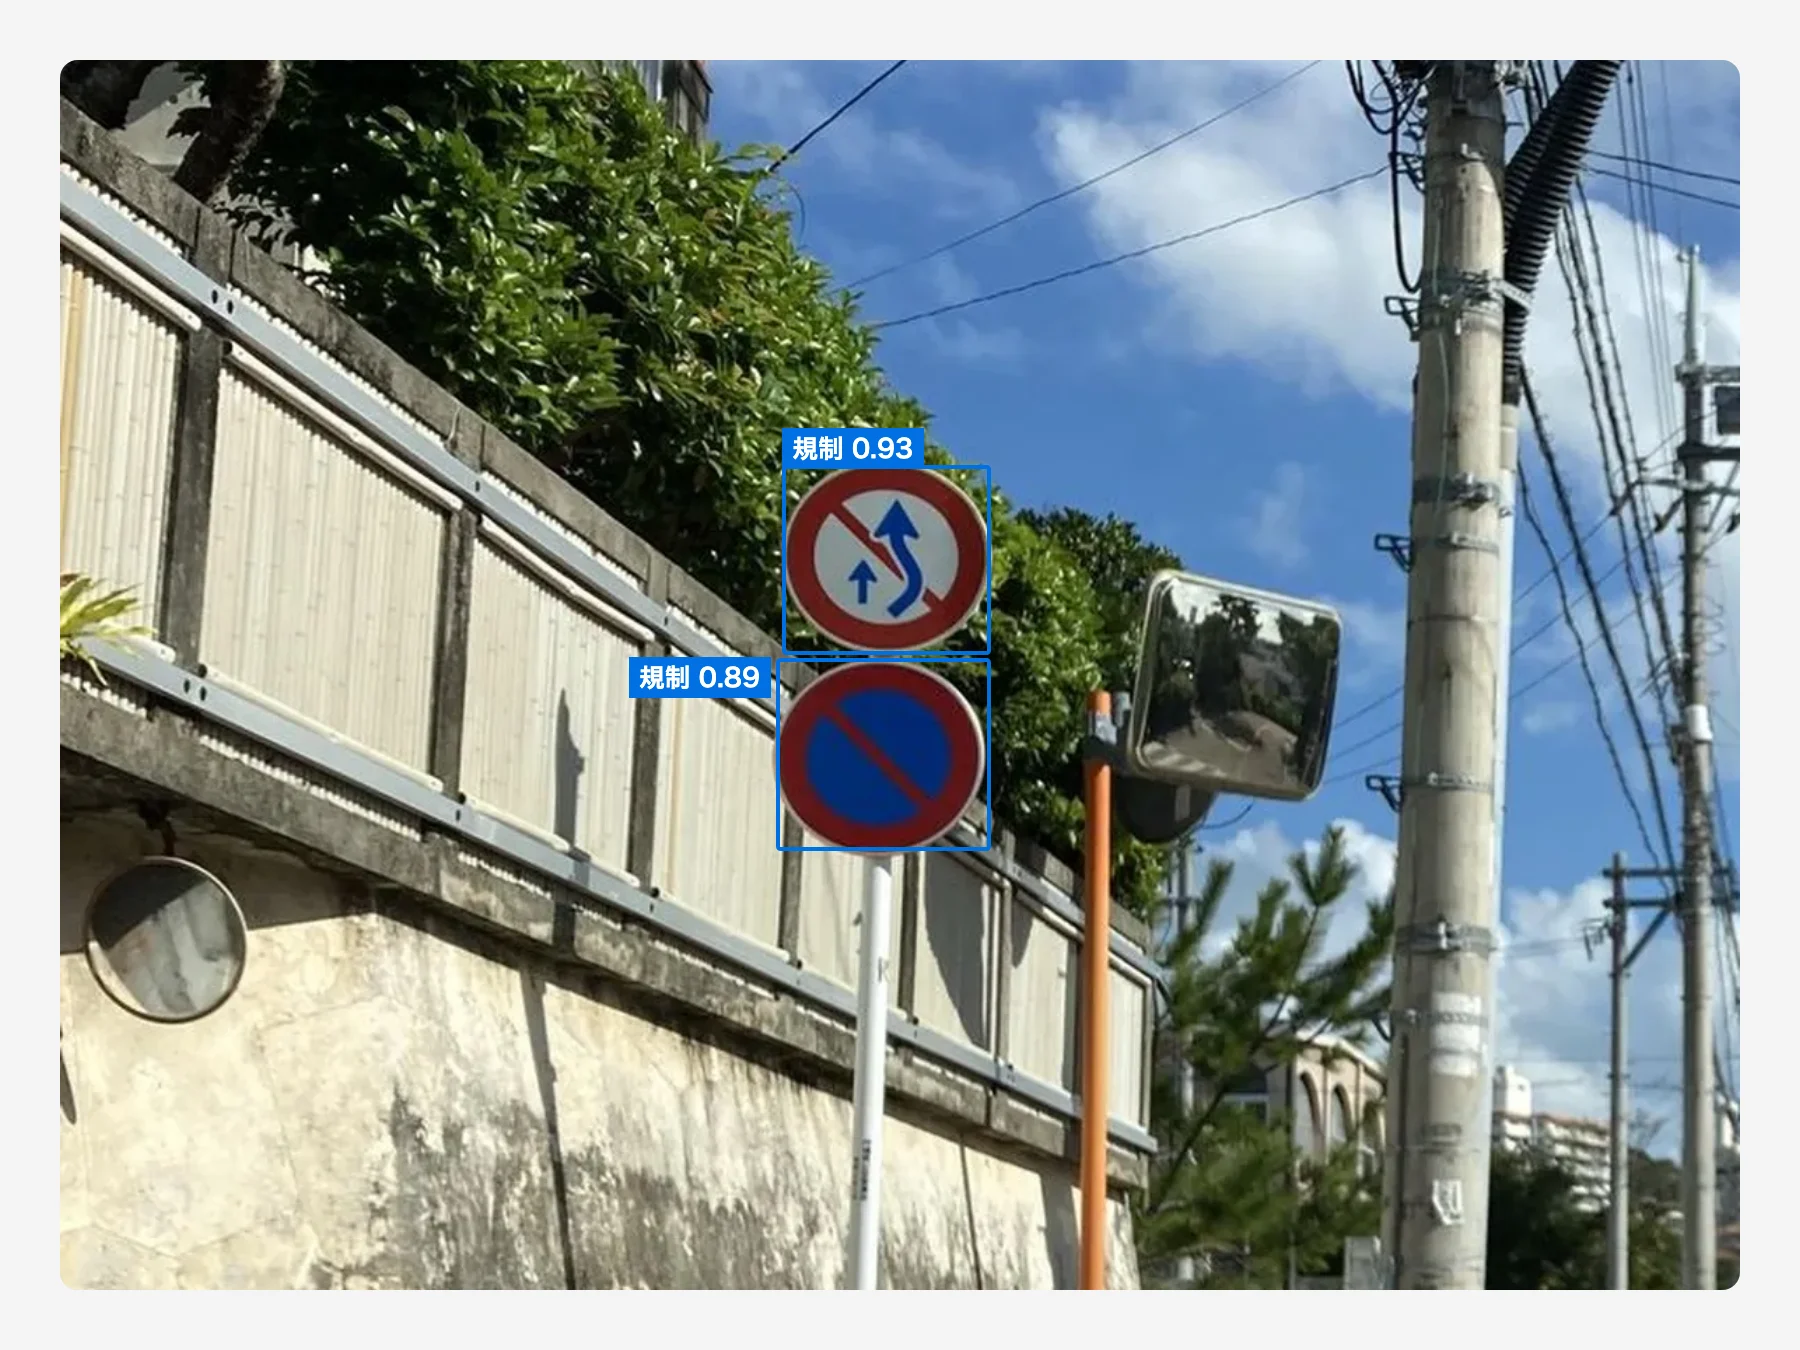
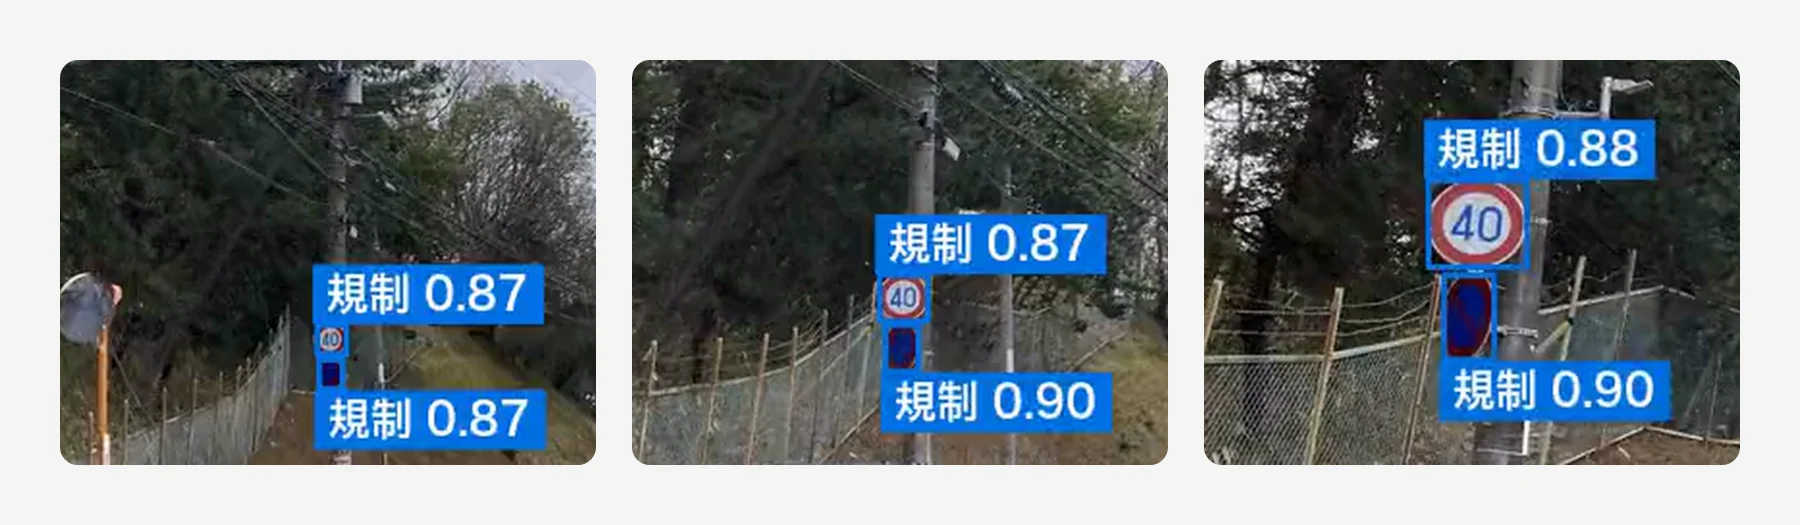
モデルは、支柱を含めず標識そのものを検出します。1本の支柱に本標識と補助標識が付いていれば、標識ごとに別の検出枠になります。店の看板・信号機・標識の裏面など、標識に似た物は別のクラス(種類)として学習させ、出力からは除いています。
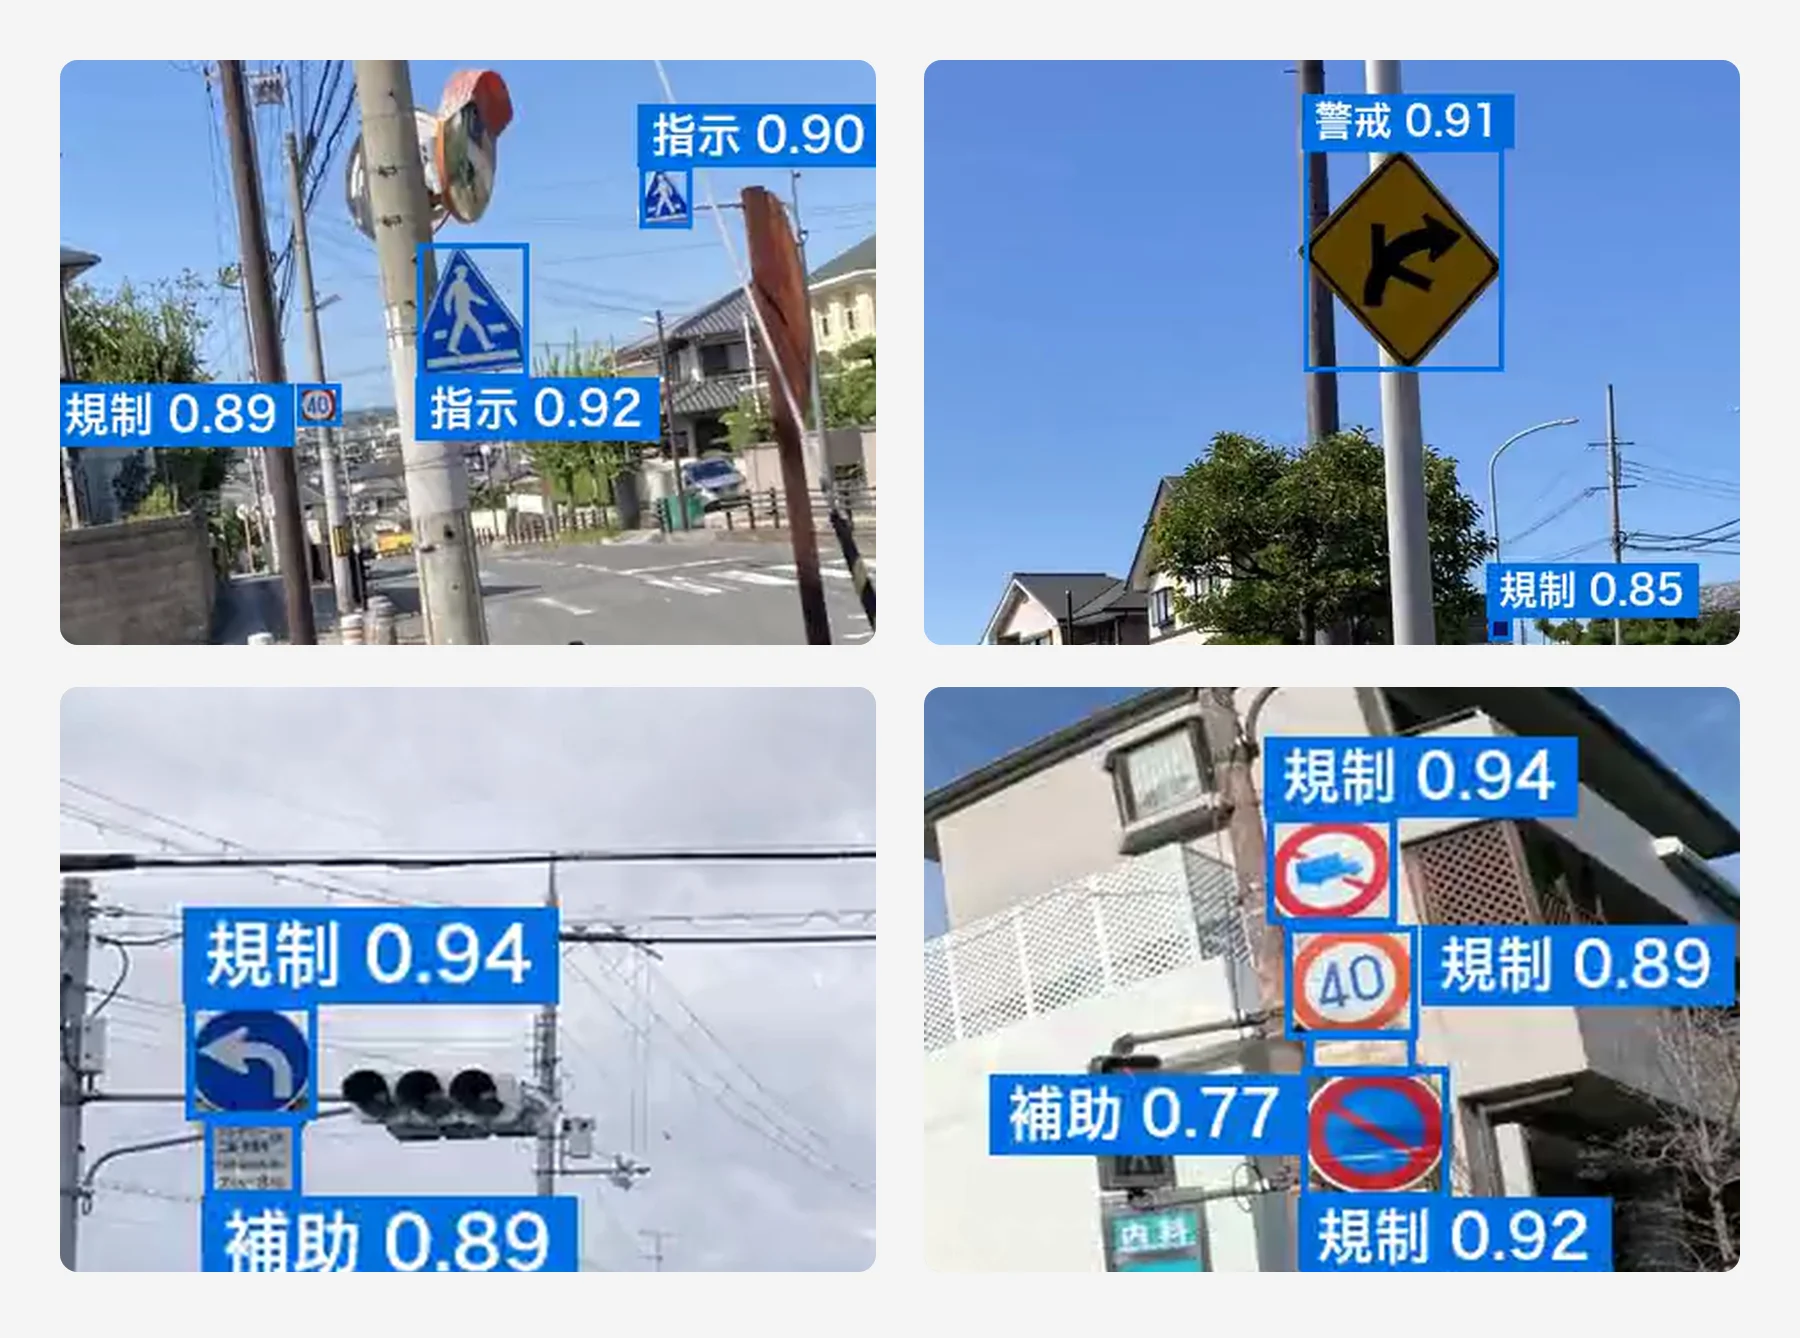
1枚の画像は、長辺を1280ピクセルに縮め、16:9なら下の16ピクセルを灰色で埋めて横1280×縦736にしてから、モデルに入力します。モデルは1枚につき200件の候補を、位置とクラスごとのスコア(確からしさ、0〜1)で返します。クラスごとに重複した候補を1つにまとめ(NMS)、スコアが0.5以上のものを標識として扱います。
YOLOX-Tiny と同じ構造のモデルを、一から学習させました。事前学習の重みは使っていません。標識の種類(一時停止・最高速度など)までは分けません。
どのくらい見つけられる?
学習に使っていない7つの地域で撮られたテスト用の596枚(標識988枚)で数えた結果です。しきい値は、テスト用の画像を見る前に決めました。
- 再現率(見逃さずに検出できた割合): 0.857
- 適合率(検出が正しかった割合): 0.877
- 分類の正解率(検出した標識のクラスが正しかった割合): 0.980
- 標識の写っていない画像100枚あたりの誤検知: 12.0件
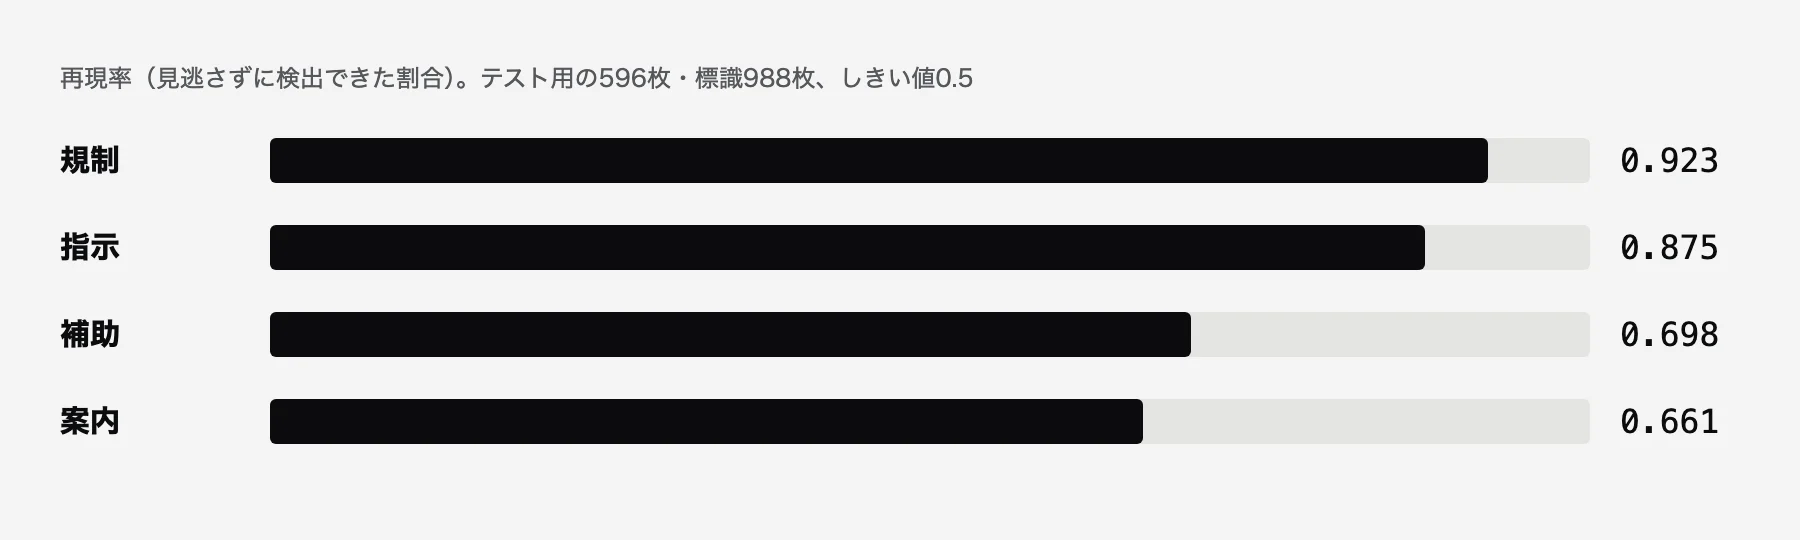
規制と指示はよく見つけ、案内(交差点名・通り名の標識を含む)と補助は見逃しやすくなります。警戒標識はテスト用に9枚しかないため、数を載せていません。テスト用の正解の枠(アノテーション)は AI が付け、開発者が一部を確かめたもので、1枚ずつの確認はしていません。
ライセンスと形式は?
重みとコードは Apache-2.0 で公開しています。業務のシステムにも製品にも組み込めて、改変して再配布することもできます。形式は PyTorch と ONNX の2つです。
使うときの注意は?
配布した ONNX は、入力が横1280×縦736で固定です。4:3の画像は小さく縮めて入れることになり、検証用の画像では再現率が0.869から0.740に下がりました。スマートフォンの横向きの動画(16:9)なら、この影響はありません。
近くで大きく写った標識は見逃しやすくなります。店の看板・施設の案内板・住所の板などを、標識と誤検知することがあります。点検や安全についての判断を、このモデルの結果だけで行わないでください。
モデルの詳しい説明(入力と出力、評価の結果、実際の写真で検出した動画): 道路標識 YOLOX-Tiny
重みの公開先: Hugging Face
同じように、決まった設備を映像から見つけるモデル作りの相談も受けています: 検知AIモデルの構築
見出し画像の写真: pika_sky / Mapillary(CC BY-SA 4.0)